本地 AI 工作台
Melix
登记模型、启动本地服务、离线对话、用自己的数据训练 LoRA 适配器,再对结果做基准测试和评测——全部在一个原生 macOS 应用和命令行里完成,跑在 Apple Silicon 上,数据不离开这台 Mac。
MelixApache-2.0macOS 15+Apple Silicon
拉普拉斯设想过一个无所不知的智者。我们从另一头做起:让模型小到能在手边的机器上训练、运行和检验,并且说得清自己有几分把握。
01gua — 已发布
4B参数。Qwen3.5-4B,语言模型的每个线性层加秩为 8 的 LoRA
30.294 → 0.060动作判断的校准误差(ECE),温度缩放前后
2截图 · 系统设置
任务
Turn on Dark Mode
已完成
下一步动作是 click 的概率
0.94
下一步目标是元素 15 的概率
0.60
示意图。概率取自模型说明里的示例。
给它一张截图、一个任务和最近几步操作,它会说出下一步是什么动作、该落在屏幕上的哪个元素,并给每个选项一个校准过的概率。代理可以只执行有把握的回答,其余的先问人。
最有把握的那一半回答里,元素定位的准确率;全部回答为 0.524
训练题目取自 374 段公开屏幕录制教程里切出的 32,730 步操作,涵盖从 Blender 到 Logic Pro 的七类软件;测试用的是它从未见过的 99 段视频里的 9,972 步。
02缘起
最强的模型住在数据中心,而大多数人、实验室和小公司不在那里。两者之间隔着一串具体的数字:模型要占多少内存,一次回答要等多久,把它改到新任务上要花多少,它的某一次判断值得几分信任。
我们研究的就是这些数字——在模型里,在训练和检验模型的数据里,也在运行模型的系统里。
03同样已发布
本地 AI 工作台
登记模型、启动本地服务、离线对话、用自己的数据训练 LoRA 适配器,再对结果做基准测试和评测——全部在一个原生 macOS 应用和命令行里完成,跑在 Apple Silicon 上,数据不离开这台 Mac。
本机语音输入
按下快捷键说话,文字就落进你正在输入的地方。语音在 Mac 本机识别,有几种本地引擎可选,其中 Qwen3-ASR 能处理中英混说。
04研究
能力
已发布 · gua v1、v2
用不大的算力,把开源模型改到具体的真实任务上,再做好校准,让它报出的把握真有意义。
内部在用
把公开素材变成训练数据,然后审计它。按来源划分数据,报告置信区间,讲清结果在哪里不再成立。
已发布 · Melix、SayIt
让整套流程留在一台机器上:运行、提供服务、适配和评测模型,把语音转成文字,什么都不必送出去。
使用者
05方法
gua 在一台 Mac 上训练,两个版本累计约 110 小时。约束是结果的一部分,所以和结果一起报告。
新旧版本的对比,附有按轨迹配对的自助法 95% 置信区间。
训练标注由模型生成,所以我们让更强的模型按主题抽查,把查出的问题印在模型说明里。
密集的专业界面会难倒它:在 Plasticity 的 CAD 工具栏上,元素定位只有 38%。这一点也写在说明里。
06公益
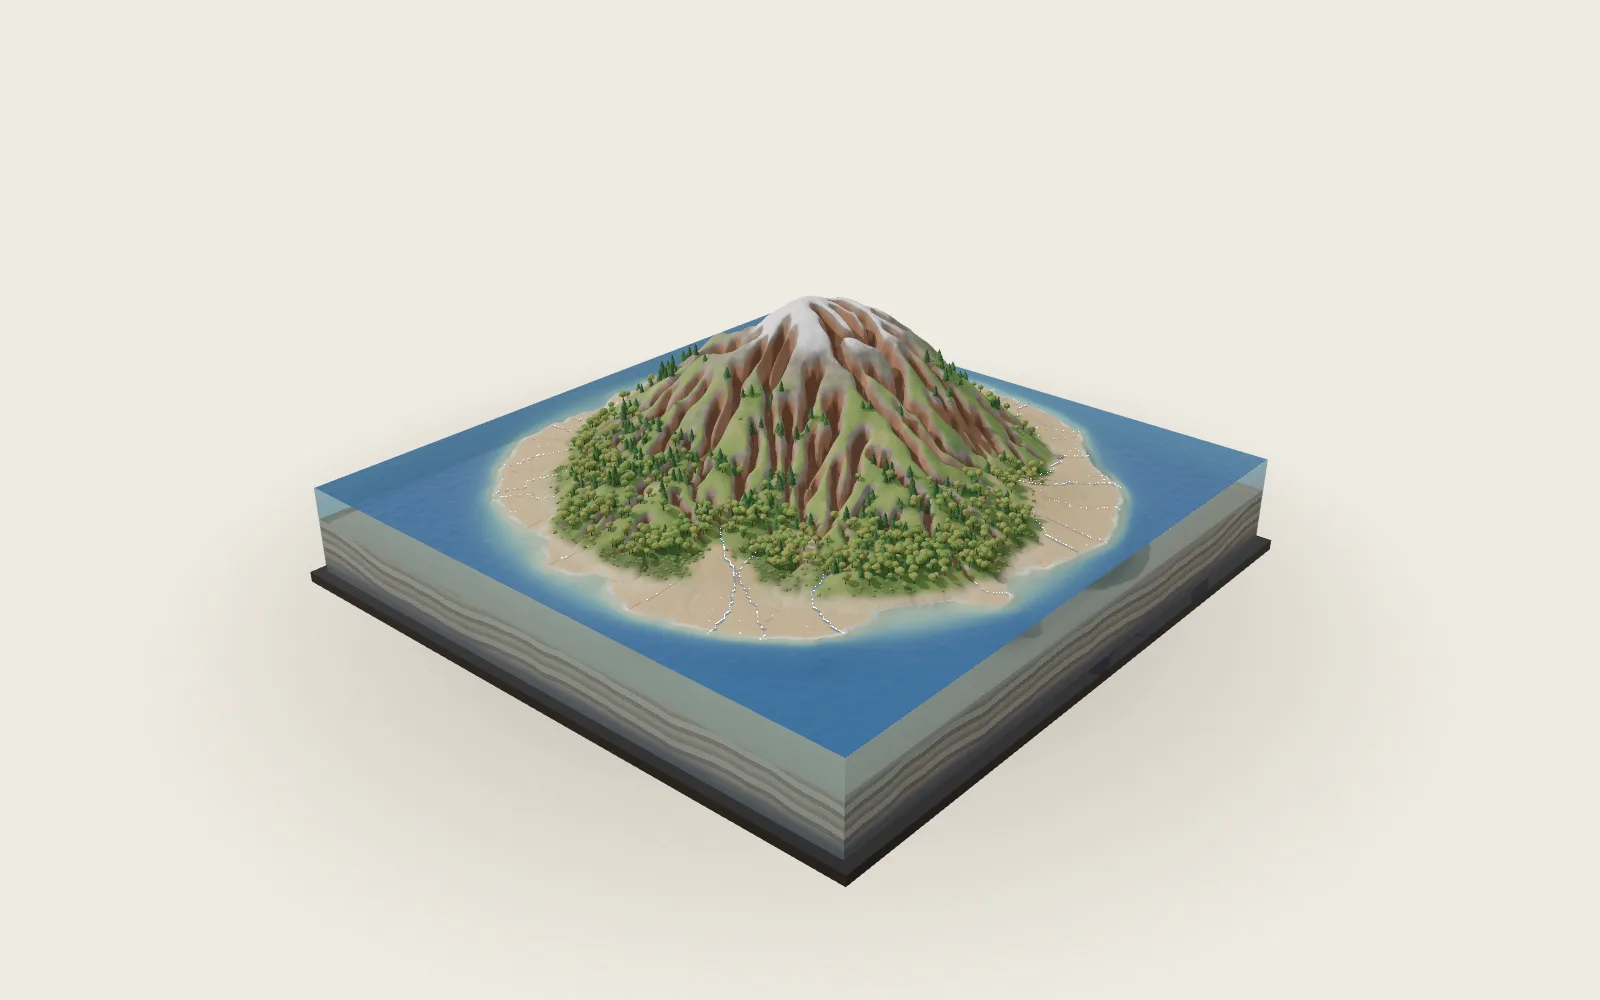
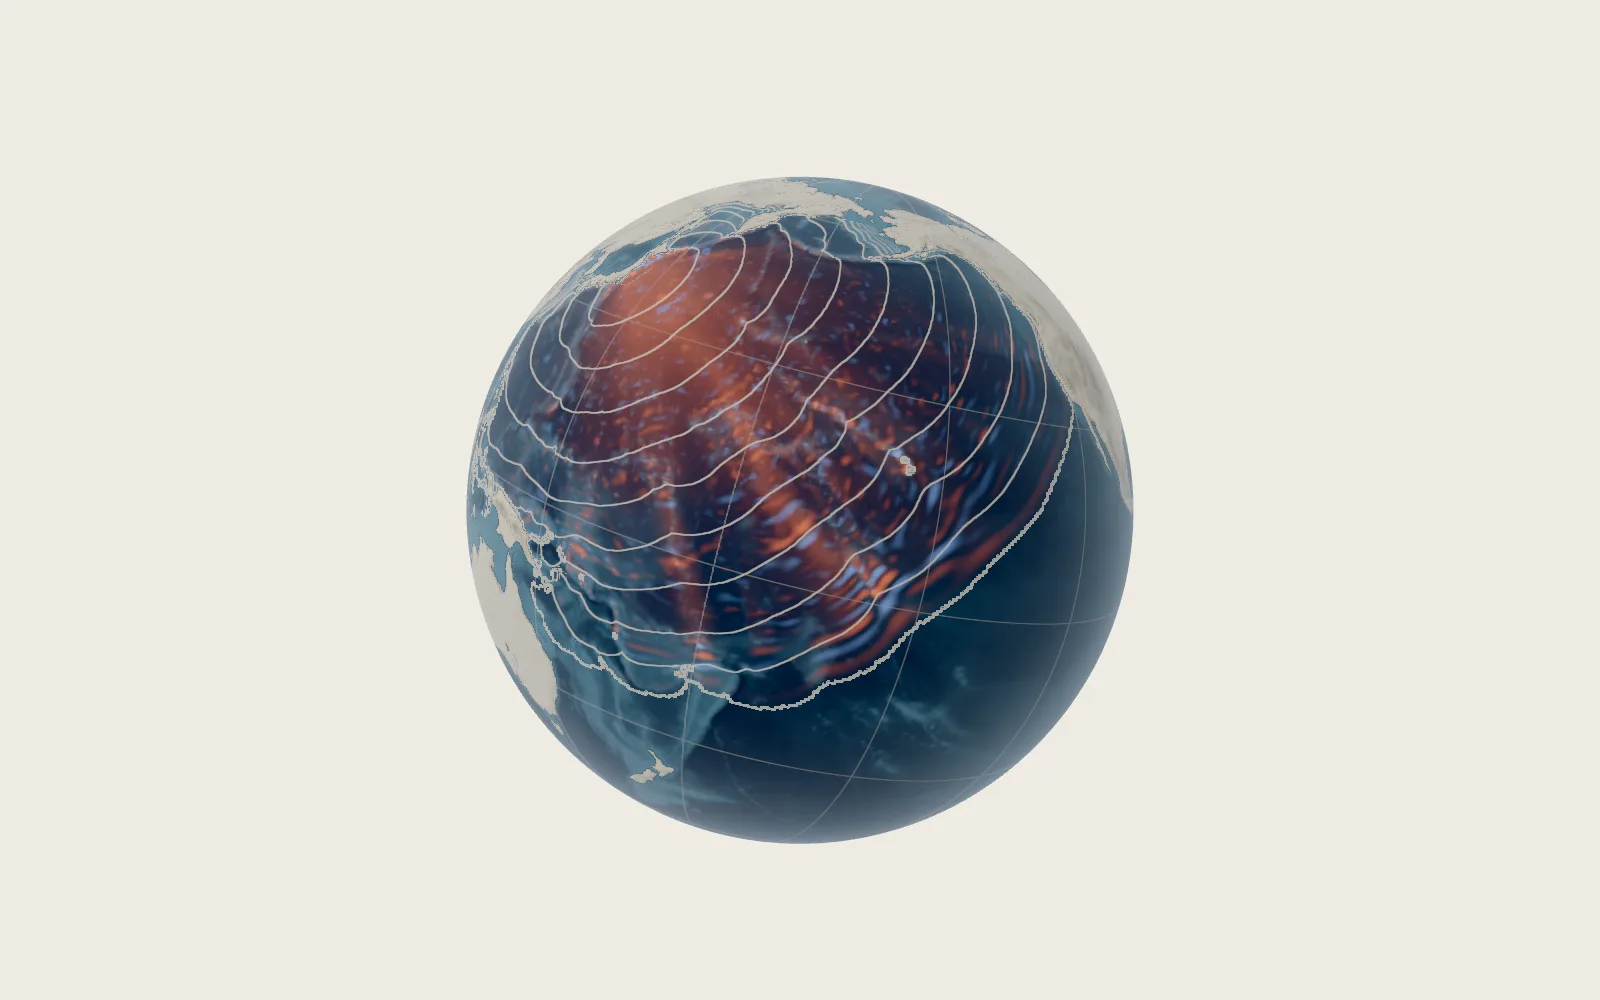
这是我们的公益项目:给孩子的四十四个能动手的世界模型。海啸越过真实的太平洋海底,雨水一点点磨平一座岛,一个小到每一步都看得清的扩散模型从噪点里画出图来。每一篇都是一段短文配一个模拟,孩子可以转动它、让它运行、把它拆开来看。中英文都有。
07合作
我们想认识研究小模型、评测和端侧推理的研究者与工程师,也想认识手里有真实任务、硬件却有限的团队。
其他地方 Hugging Face · LaplAI world.lapla.si 抖音 小红书 YouTube TikTok